从整期刊物中抽出自己的文章
期刊寄来 180 页的整期 PDF,你的文章在第 41–53 页。按范围填 41-53,输出一个 13 页的文件,文件名自动带上 _第41-53页。
使用指南
PDF 拆分把一个多页 PDF 按你给出的规则切成若干个独立的 PDF 文件,全部计算在浏览器内完成,源文件不上传也不被修改。
更新于 2026-09-09复核:owner4 个来源约 12 分钟读完
PDF 拆分把一个多页 PDF 按你给出的规则切成若干个独立的 PDF 文件,全部计算在浏览器内完成,源文件不上传也不被修改。
需要它的场景往往是「一份文件,多个去处」:一本合同要把签字页单独发给对方;扫描仪把整叠材料扫成了一个 100 页的文件,而每 4 页才是一个人的表格;期刊寄来整期 PDF,你只想留下自己的那篇;或者反过来,某个平台限制单文件页数,你得把长文档切成几段上传。
它提供四种切法:按范围(每个范围一个文件,也可以合成一个)、每 N 页(等分)、选中页(在缩略图里点选,抽成一个新文件)和逐页(每页一个文件)。多于一个输出文件时自动打包成 zip 下载,只有一个时直接下载 PDF。
拆分作用于「当前排列」而不是原始文件:如果你先在中间区域删掉了空白页、把颠倒的页转正,拆分的页码和内容都以整理后的状态为准。这让「先整理再拆」成为一步操作,但也意味着你输入的页码指的是屏幕上的序号。
1-3,5,8-10,每个范围输出一个文件;打开「把所有范围合并为一个文件」则把这些范围按输入顺序拼成一个。
- 每 N 页:填写「每份页数」,从第 1 页起等分,最后一份可能不足 N 页。
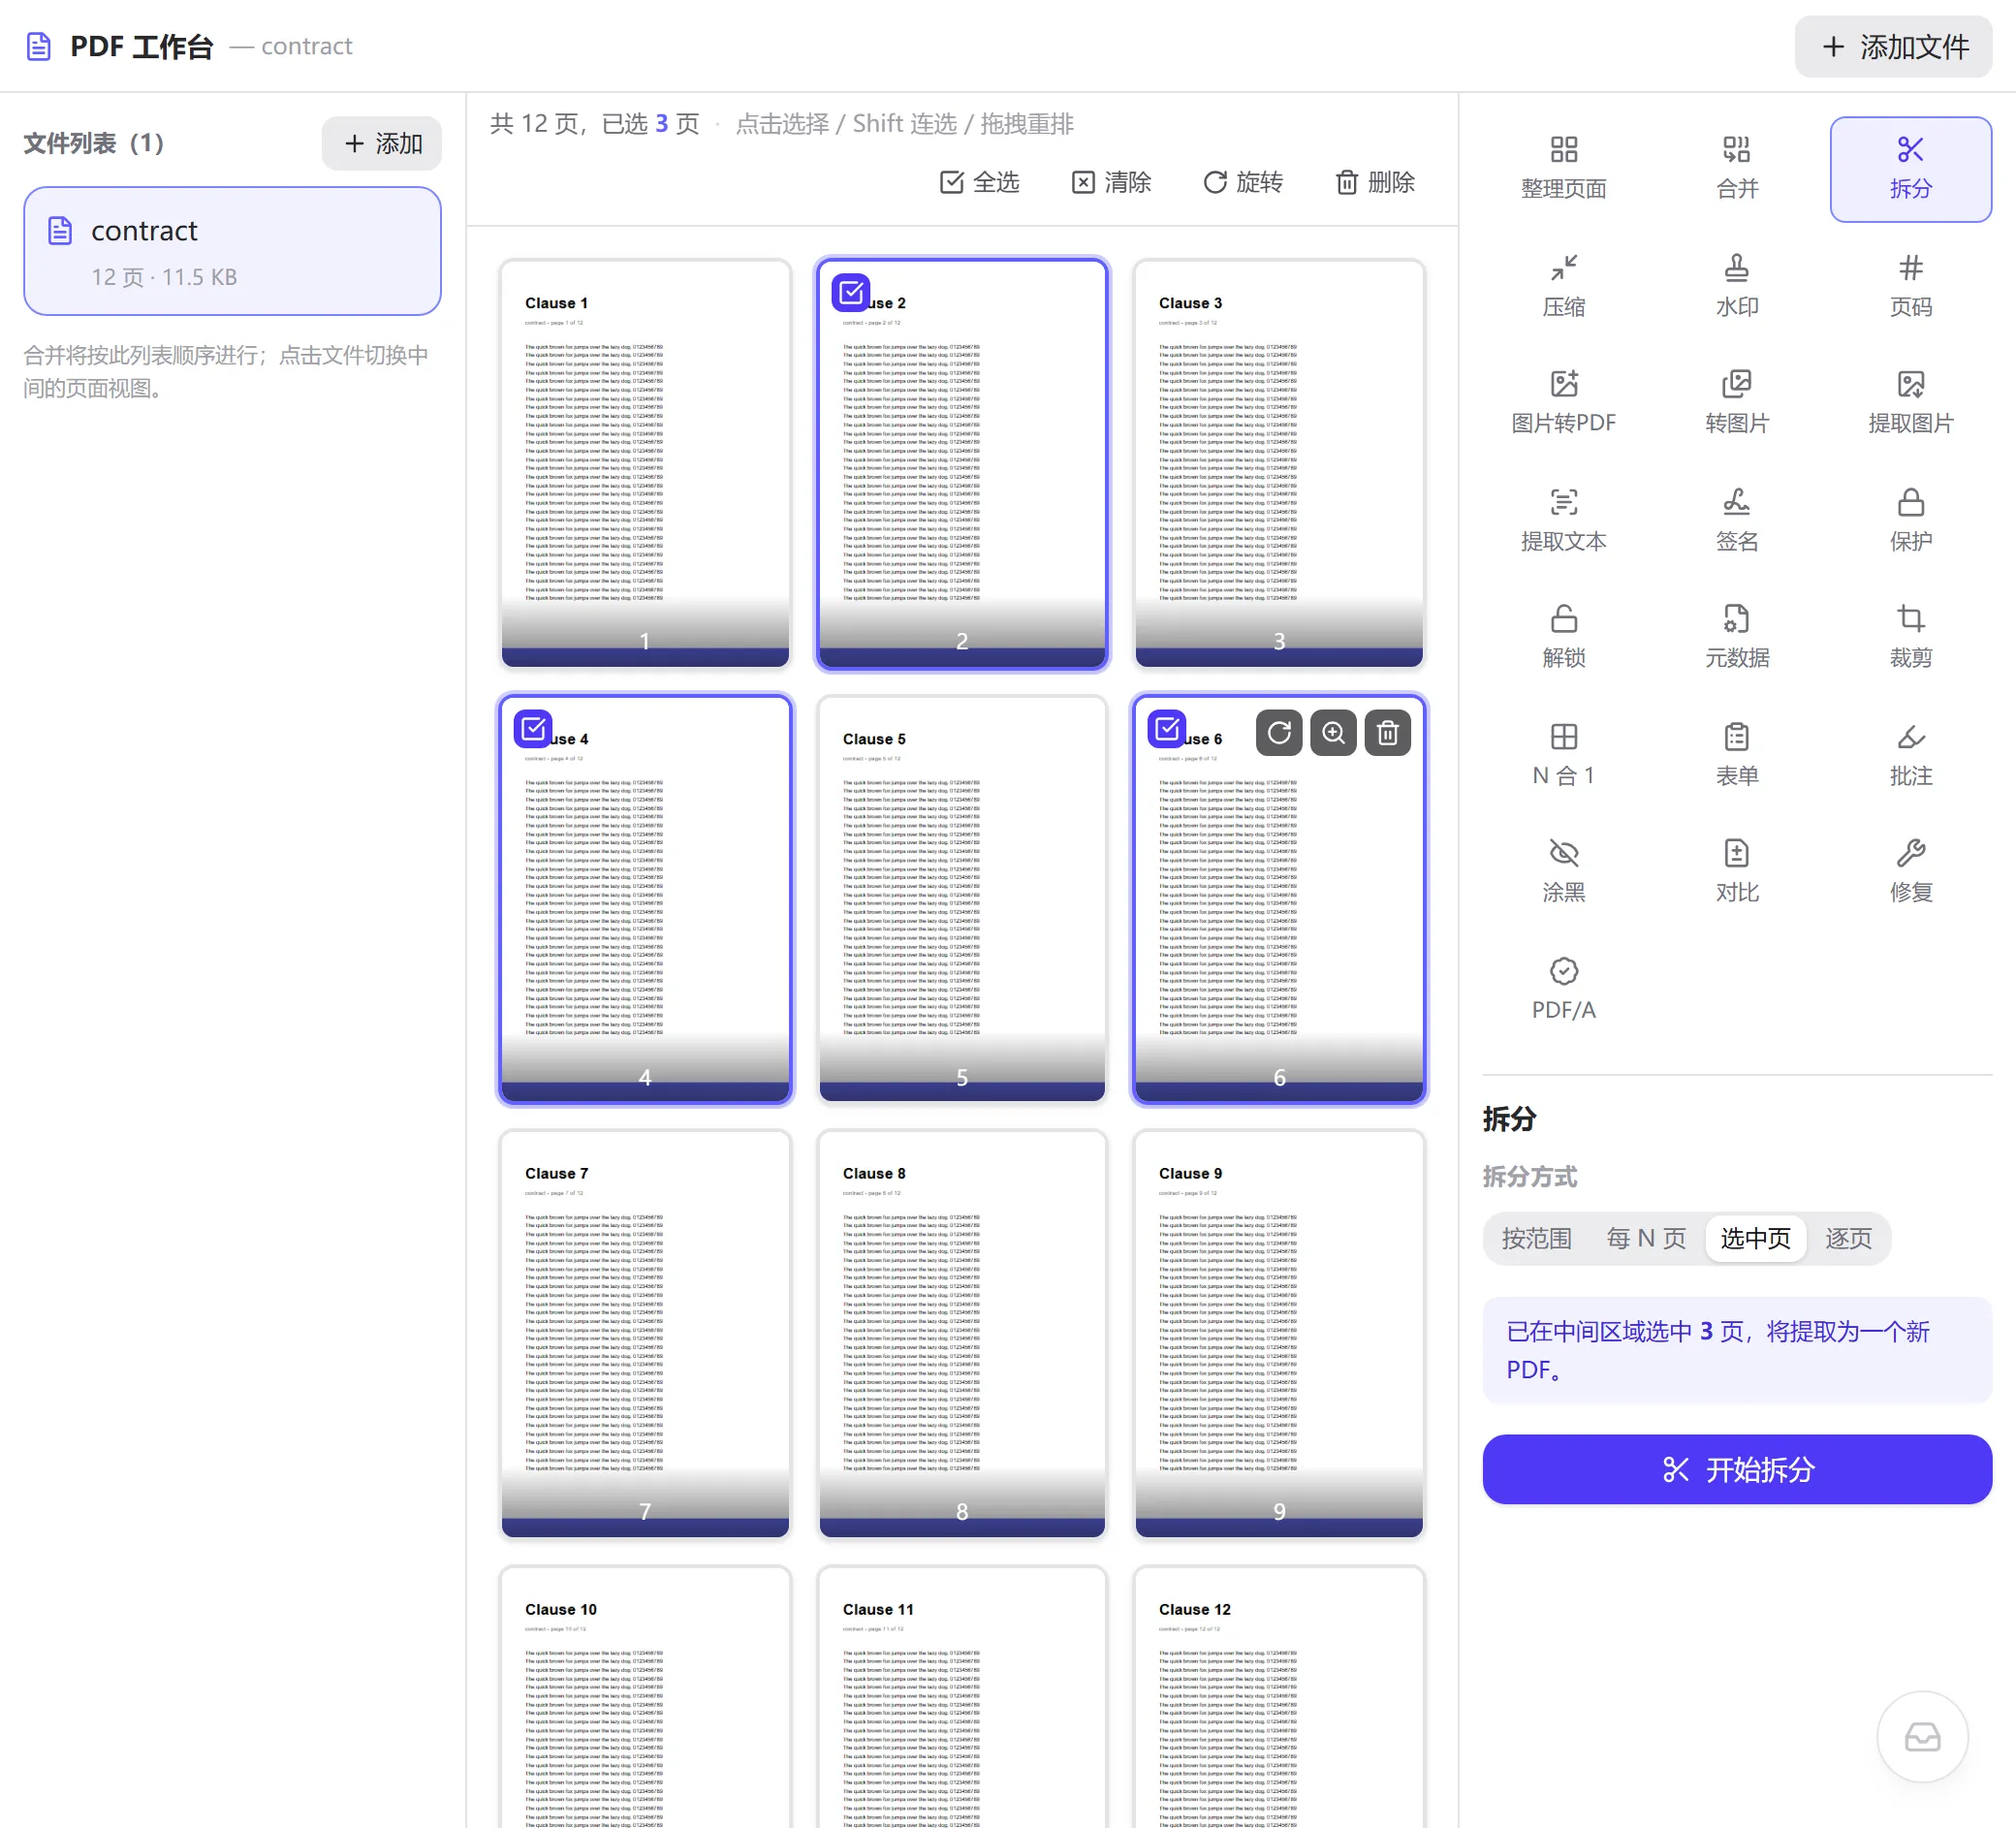
- 选中页:先在中间区域点选页面(Shift 连选一段),面板会显示已选页数,输出一个只含这些页的 PDF。
- 逐页:每页导出一个单页 PDF,全部打包成 zip。contract_第1-3页.pdf;多个文件打包为 contract_拆分.zip。对一份 12 页的合同(contract.pdf,11.5 KB)做两次拆分,真实输出如下:
范围语法允许的写法:
会被拒绝并提示原因的写法:0-3(页码从 1 开始)、5-2(起始页大于结束页)、10-15(超出总页数时提示实际页数)、a-b(无法识别)。
按范围:1-3,5,8-
  contract_拆分.zip(10.2 KB),内含 3 个文件
    contract_第1-3页.pdf     3 页
    contract_第5页.pdf       1 页
    contract_第8-12页.pdf    5 页     ← 「8-」表示从第 8 页到最后
  未出现在任何范围里的第 4、6、7 页不会输出

每 N 页:N = 4
  contract_拆分.zip(12.8 KB),内含 3 个文件
    contract_第1-4页.pdf
    contract_第5-8页.pdf
contract_第9-12页.pdf1-3,5,8-10 逗号分隔,连字符表示闭区间
1-3、5 8-10 顿号、空格同样视为分隔符
2—5 2~5 长横线、半角波浪号会被规整为「-」
9- 到最后一页
-3 从第 1 页到第 3 页
1-3,2-6 范围可以重叠:第 2、3 页会同时出现在两个输出里一个 PDF 文件内部没有「第 5 页」这个字段。文档目录下挂着一棵页面树(Page Tree),叶子节点是一个个 /Page 对象;阅读器按深度优先遍历这棵树,遇到的第 5 个叶子就叫第 5 页。这个序号叫物理页码,与页面上印着的「5」或目录里的「第五章 …… 5」没有必然关系。
PDF 还允许在文档级定义页面标签(Page Labels),让阅读器把前言显示成 i、ii、iii,正文从 1 重新开始。本工具的范围输入使用的是物理页码,也就是缩略图下方标注的数字;如果你的文件有罗马数字前言,请按缩略图上的序号而不是页面上印的页码来填。
拆分与合并共用同一套机制:用 pdf-lib 新建空文档,按分组把页面从源文件「复制」过来。每一页被复制时,它引用的内容流、字体、图片、页级批注一起被深拷贝并重新编号;页面旋转通过 /Rotate 写入。分组之间彼此独立——第 1 组的输出文件不知道第 2 组的存在。
「每 N 页」的分组算法是从当前排列的第 1 页起每 N 页切一刀,最后一组取剩余页数;「按范围」则严格按你输入的顺序生成分组,范围重叠时页面会被复制多次;「选中页」把已选页按它们在排列中的先后顺序放进一个分组;「逐页」等价于 N = 1。
拆出的每个文件都要能独立打开,因此源文件里被多页共用的资源(最典型的是嵌入字体)会在每个输出文件里各有一份。一份 12 页、嵌入了 3 款字体的文档拆成 3 份,字体数据就存在 3 份。此外,工作台为了支持逐页整理,是一页一次复制的,同一输出文件内多页共用的字体也会被逐页复制(详见「PDF 合并」的原理一节)。上面的示例里源文件用的是 PDF 内建标准字体、没有嵌入字体数据,所以三份之和与原件相当;对嵌入字体的文档,之和会明显大于原件。
反过来,拆分也不会「解锁」任何东西:如果源文件的某页含有一张 20 MB 的扫描图,拆出的那页就是 20 MB。
和合并一样,复制页面只带走页面级内容。书签、表单字段定义、附件、命名目标、文档属性等文档级结构不会进入任何一个输出文件;跨页链接如果依赖命名目标则会失效。带数字签名的文件拆分后签名失效——这是所有重写 PDF 结构的操作的共同结果,不是拆分特有的。
多个输出文件用 JSZip 在浏览器内打包成一个 zip(DEFLATE 压缩级别 6)。PDF 内部的流通常已经压缩过,所以 zip 几乎不会再缩小体积,它的作用只是让浏览器一次下载多个文件。解压后每个 PDF 都是完整独立的。
8-10,1-3 会输出一个先放第 8–10 页、再放第 1–3 页的文件。这比「拆分—再合并」少一轮下载,也是一种快速重排。1-4,1,5-8,1,9-12 会得到 5 个文件,其中三个是 4 页的分册、两个是单独的封面;如果你想要的是「每个分册都带封面」,更直接的做法是对每个分册各跑一次「合并为一个文件」的 1,5-8。期刊寄来 180 页的整期 PDF,你的文章在第 41–53 页。按范围填 41-53,输出一个 13 页的文件,文件名自动带上 _第41-53页。
行政人员一次扫描了 30 份 3 页的入职表。用「每 N 页」N = 3 得到 30 个文件,打包 zip 下载后按顺序对照名单重命名。
12 页合同只需把最后一页发给对方签字。在缩略图中点选第 12 页,用「选中页」输出;或者按范围填 12。
平台限制单个 PDF 不超过 50 页,手头是 230 页的培训手册。「每 N 页」N = 50 输出 5 个文件,最后一个 30 页。
不会。源文件只被读取进内存,所有输出都是新建的文档。关闭页面后内存释放,你的原文件保持原样。
浏览器一次只能触发一个下载,多个文件打包成 zip 是让你一次拿到全部结果的方式。只有一个输出时直接下载 PDF。zip 用标准 DEFLATE 压缩,任何系统都能解压。
目前不能。工具不解析书签结构,也不识别正文。请先在阅读器里查看章节起始页码,再按范围输入。
拆分本身按页复制,速度与页数和每页体积成正比;生成缩略图也会占用一部分时间。手机浏览器的内存更紧张,几百页的扫描件建议在电脑上处理。
书签属于文档级结构,按页复制不会带走它。这是实现方式的固有代价,输出文件本身是完整的。
结果一样,入口不同:选中页靠点选缩略图,适合零散、肉眼确认的页面;按范围靠输入,适合成段、页数多的情况。两者输出的都是一个文件(按范围默认每个范围一个文件,打开合并开关后变为一个)。
文件在浏览器内读取、解析和重建,不经过任何服务器。页面缩略图由 pdf.js 在本机渲染,输出文件由 pdf-lib 在本机生成,zip 打包同样在本机完成。断网状态下依然可用;关闭页面后内存中的数据即被释放。
copyPages 与文档创建 API:https://pdf-lib.js.org/(访问日期:2026-09-08)更新于 2026-09-09 · 复核:owner
按页范围、每 N 页、选中页拆分或逐页导出
所有处理均在你的浏览器本地完成,文件不会上传到任何服务器