학술지 한 권에서 내 논문만 뽑기
180페이지짜리 학술지 PDF를 받았고 내 논문은 41–53페이지에 있습니다. 범위에 41-53을 넣으면 13페이지짜리 파일이 나오고 이름에 _41-53페이지가 자동으로 붙습니다.
Guide
PDF 분할은 여러 페이지짜리 PDF를 지정한 규칙에 따라 여러 개의 독립된 PDF 파일로 나눕니다. 계산은 모두 브라우저 안에서 끝나고 원본 파일은 업로드되지도, 수정되지도 않습니다.
2026-09-09 업데이트4 sources8 min read
PDF 분할은 여러 페이지짜리 PDF를 지정한 규칙에 따라 여러 개의 독립된 PDF 파일로 나눕니다. 계산은 모두 브라우저 안에서 끝나고 원본 파일은 업로드되지도, 수정되지도 않습니다.
이 기능이 필요한 순간은 대개 「문서 하나, 갈 곳은 여럿」입니다. 계약서에서 서명 페이지를 따로 떼어 상대에게 보낼 때, 스캐너가 서류 뭉치를 100페이지짜리 파일 하나로 만들어 버렸는데 4페이지마다 한 사람의 서식일 때, 학술지 한 권 전체를 받았지만 내 논문만 남기고 싶을 때, 반대로 어떤 플랫폼이 파일당 페이지 수를 제한해 긴 문서를 잘라 올려야 할 때 쓰입니다.
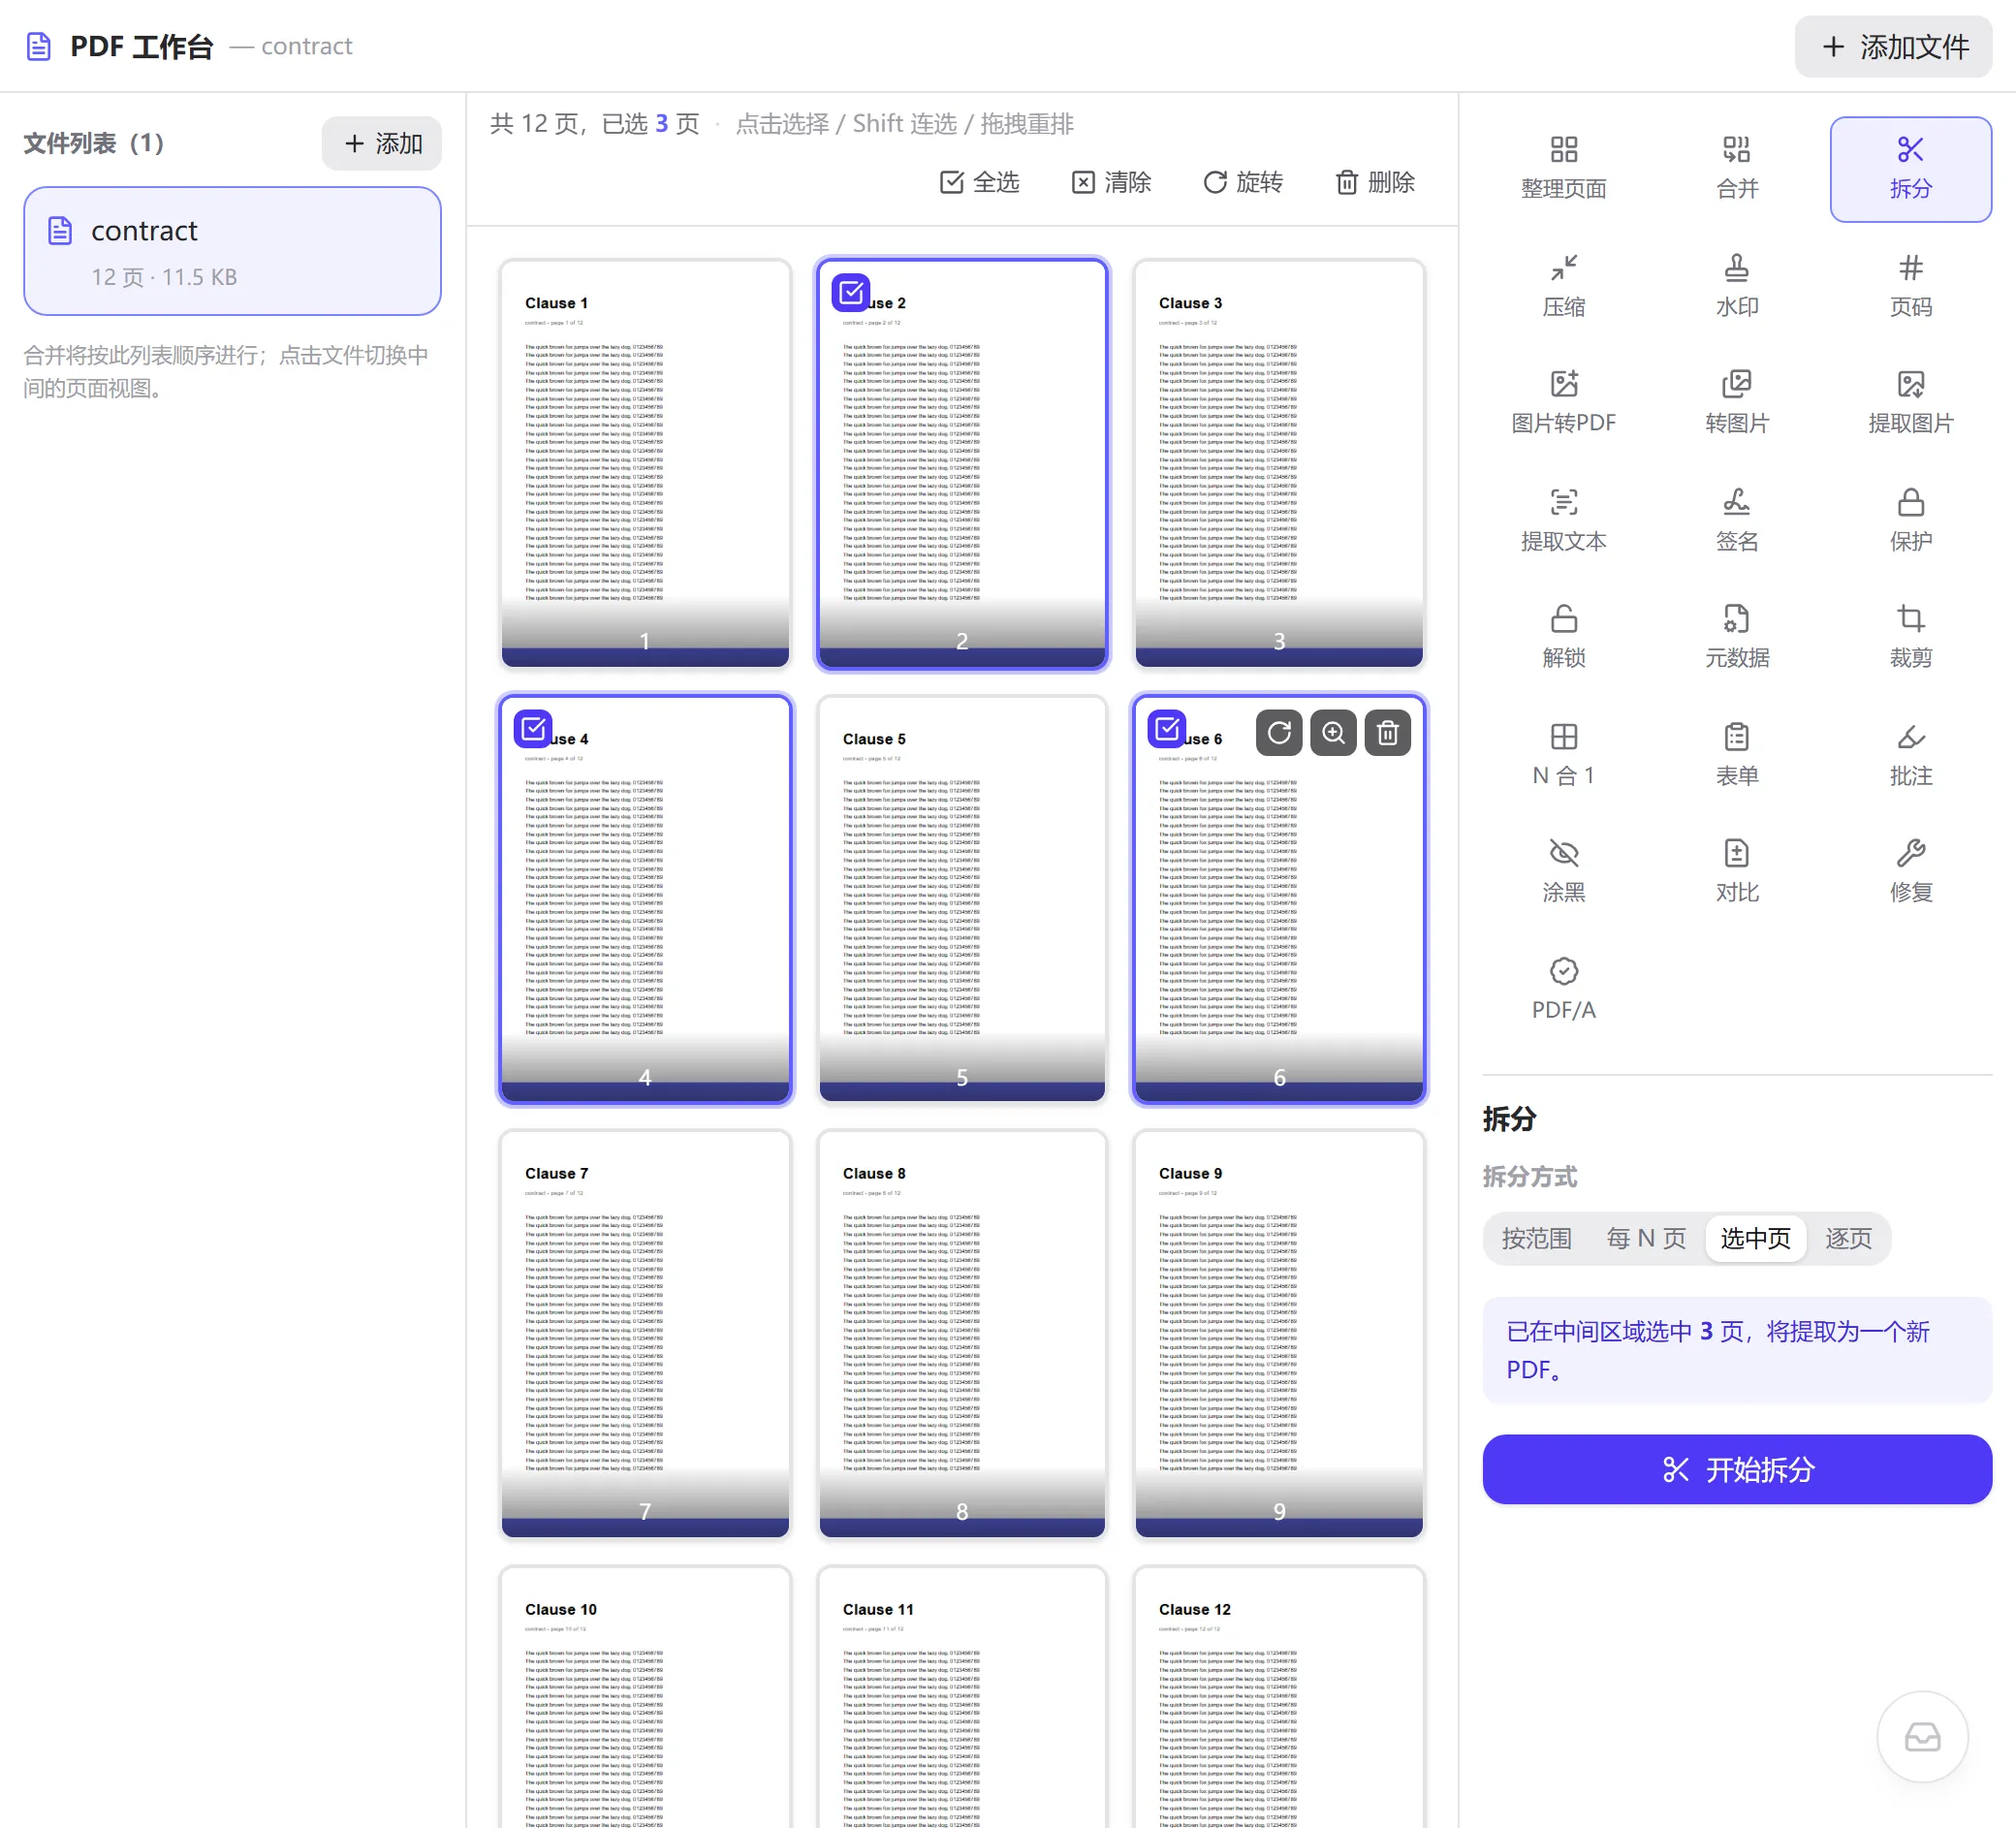
나누는 방식은 네 가지입니다. 범위 지정(범위마다 파일 하나, 하나로 합칠 수도 있음), N페이지마다(균등 분할), 선택 페이지(썸네일에서 클릭해 뽑아내 새 파일로 만들기), 페이지마다(한 페이지에 파일 하나). 출력 파일이 둘 이상이면 자동으로 zip으로 묶어 내려받고, 하나뿐이면 PDF로 바로 내려받습니다.
분할은 원본 파일이 아니라 「현재 순서」를 기준으로 합니다. 가운데 영역에서 빈 페이지를 지우거나 뒤집힌 페이지를 바로 세워 두었다면 페이지 번호와 내용 모두 정리된 상태를 따릅니다. 「정리한 뒤 나누기」가 한 번에 되는 대신, 입력하는 페이지 번호는 화면에 보이는 번호라는 뜻입니다.
1-3,5,8-10처럼 입력하면 범위마다 파일 하나가 나옵니다. 「모든 범위를 파일 하나로 병합」을 켜면 입력한 순서대로 하나로 이어 붙입니다.
- N페이지마다: 「파일당 페이지 수」를 채우면 1페이지부터 균등하게 나뉘고 마지막 묶음은 N페이지보다 적을 수 있습니다.
- 선택 페이지: 가운데 영역에서 페이지를 클릭합니다(Shift로 구간 선택). 패널에 선택한 페이지 수가 표시되고, 그 페이지만 담은 PDF 하나가 출력됩니다.
- 페이지마다: 페이지마다 한 장짜리 PDF를 만들어 전부 zip으로 묶습니다.contract_1-3페이지.pdf이고, 파일이 여러 개면 contract_분할.zip으로 묶입니다.12페이지 계약서(contract.pdf, 11.5 KB)를 두 방식으로 나눈 실제 출력입니다:
범위 문법에서 허용되는 표기:
거부되고 이유가 안내되는 표기: 0-3(페이지는 1부터 시작), 5-2(시작 페이지가 끝 페이지보다 큼), 10-15(전체 페이지 수를 넘으면 실제 페이지 수를 안내), a-b(인식 불가).
범위 지정: 1-3,5,8-
  contract_분할.zip (10.2 KB), 파일 3개 포함
    contract_1-3페이지.pdf    3페이지
    contract_5페이지.pdf      1페이지
    contract_8-12페이지.pdf   5페이지    ← 「8-」은 8페이지부터 끝까지라는 뜻
  어떤 범위에도 없는 4·6·7페이지는 출력되지 않음

N페이지마다: N = 4
  contract_분할.zip (12.8 KB), 파일 3개 포함
    contract_1-4페이지.pdf
    contract_5-8페이지.pdf
contract_9-12페이지.pdf1-3,5,8-10 쉼표로 구분, 하이픈은 닫힌 구간
1-3、5 8-10 중국어 구분점(、)과 공백도 구분자로 인식
2—5 2~5 긴 줄표와 물결표는 「-」로 정규화
9- 마지막 페이지까지
-3 1페이지부터 3페이지까지
1-3,2-6 범위는 겹칠 수 있음: 2·3페이지가 두 출력에 모두 들어감PDF 파일 안에 「5페이지」라는 필드는 없습니다. 문서 카탈로그 아래에 페이지 트리(Page Tree)가 매달려 있고 잎 노드가 하나씩 /Page 객체입니다. 뷰어는 이 트리를 깊이 우선으로 순회하면서 만나는 다섯 번째 잎을 5페이지라고 부릅니다. 이 번호를 물리 페이지 번호라고 하며, 페이지에 인쇄된 「5」나 목차의 「제5장 …… 5」와 반드시 일치하지는 않습니다.
PDF는 문서 수준에서 페이지 라벨(Page Labels)을 정의해 뷰어가 서문을 i, ii, iii으로 보여 주고 본문은 1부터 다시 시작하게 할 수도 있습니다. 이 도구의 범위 입력은 물리 페이지 번호, 즉 썸네일 아래에 적힌 숫자를 씁니다. 로마 숫자 서문이 있는 파일이라면 페이지에 인쇄된 번호가 아니라 썸네일의 번호를 입력하세요.
분할과 병합은 같은 구조를 공유합니다. pdf-lib으로 빈 문서를 만들고 그룹별로 원본에서 페이지를 「복사」해 옵니다. 페이지 하나가 복사될 때 그 페이지가 참조하는 내용 스트림, 글꼴, 이미지, 페이지 수준 주석이 함께 깊은 복사되고 번호가 다시 매겨지며, 페이지 회전은 /Rotate로 기록됩니다. 그룹끼리는 서로 독립적이라 1번 그룹의 출력 파일은 2번 그룹의 존재를 모릅니다.
「N페이지마다」의 그룹 알고리즘은 현재 순서의 1페이지부터 N페이지마다 한 번씩 자르고 마지막 그룹은 남은 페이지를 가져갑니다. 「범위 지정」은 입력한 순서 그대로 그룹을 만들고 범위가 겹치면 페이지가 여러 번 복사됩니다. 「선택 페이지」는 선택한 페이지를 배열 순서대로 그룹 하나에 담고, 「페이지마다」는 N = 1과 같습니다.
나눠진 파일은 각각 따로 열려야 하므로 원본에서 여러 페이지가 공유하던 자원(가장 대표적인 것이 임베드 글꼴)이 출력 파일마다 한 벌씩 들어갑니다. 글꼴 3개를 임베드한 12페이지 문서를 3개로 나누면 글꼴 데이터가 3벌 생깁니다. 여기에 더해 작업 공간은 페이지별 정리를 지원하기 위해 페이지를 한 장씩 복사하므로, 같은 출력 파일 안에서 여러 페이지가 공유하는 글꼴도 페이지마다 복사됩니다(자세한 내용은 「PDF 병합」의 동작 원리를 참고하세요). 위 예시의 원본은 PDF 내장 표준 글꼴을 쓰고 임베드 글꼴 데이터가 없어서 세 조각의 합이 원본과 비슷하지만, 글꼴을 임베드한 문서라면 합이 원본보다 확실히 커집니다.
반대 경우도 마찬가지입니다. 분할이 무언가를 「풀어 주는」 일은 없습니다. 원본의 한 페이지에 20 MB짜리 스캔 이미지가 들어 있으면 나눠진 그 페이지도 20 MB입니다.
병합과 마찬가지로 페이지 복사는 페이지 수준 내용만 가져갑니다. 책갈피, 양식 필드 정의, 첨부 파일, 이름 있는 대상, 문서 속성 같은 문서 수준 구조는 어떤 출력 파일에도 들어가지 않으며, 이름 있는 대상에 의존하는 페이지 간 링크는 끊어집니다. 디지털 서명이 있는 파일은 분할하면 서명이 무효가 됩니다. 이는 PDF 구조를 다시 쓰는 모든 작업에 공통된 결과이지 분할만의 특징이 아닙니다.
여러 출력 파일은 JSZip이 브라우저 안에서 하나의 zip으로 묶습니다(DEFLATE 압축 레벨 6). PDF 내부 스트림은 대개 이미 압축되어 있어서 zip을 씌워도 용량은 거의 줄지 않습니다. zip의 역할은 브라우저가 여러 파일을 한 번에 내려받게 하는 것뿐입니다. 압축을 풀면 각 PDF는 완전하고 독립적입니다.
8-10,1-3은 8–10페이지를 먼저, 1–3페이지를 뒤에 담은 파일 하나를 만듭니다. 분할 후 다시 병합하는 것보다 다운로드가 한 번 줄고, 빠른 재정렬 수단으로도 쓸 수 있습니다.1-4,1,5-8,1,9-12는 4페이지짜리 조각 셋과 표지 단독 둘, 모두 5개 파일을 만듭니다. 「조각마다 표지를 붙이고 싶다」면 각 조각에 1,5-8로 「파일 하나로 병합」을 한 번씩 돌리는 편이 더 직접적입니다.180페이지짜리 학술지 PDF를 받았고 내 논문은 41–53페이지에 있습니다. 범위에 41-53을 넣으면 13페이지짜리 파일이 나오고 이름에 _41-53페이지가 자동으로 붙습니다.
담당자가 3페이지짜리 입사 서류 30부를 한 번에 스캔했습니다. 「N페이지마다」에서 N = 3으로 30개 파일을 얻고, zip을 풀어 명단 순서대로 이름을 바꿉니다.
12페이지 계약서에서 마지막 페이지만 상대에게 서명받으러 보내면 됩니다. 썸네일에서 12페이지를 클릭해 「선택 페이지」로 출력하거나 범위에 12를 넣습니다.
플랫폼이 PDF 한 개당 50페이지를 넘지 못하게 하는데 교육 교재가 230페이지입니다. 「N페이지마다」에서 N = 50으로 5개 파일을 만들면 마지막은 30페이지입니다.
아니요. 원본은 메모리로 읽기만 하고 모든 출력은 새로 만든 문서입니다. 페이지를 닫으면 메모리가 풀리고 원본은 그대로 남습니다.
브라우저는 한 번에 다운로드 하나만 시작할 수 있어서, 여러 파일을 zip으로 묶는 것이 결과를 한 번에 받는 방법입니다. 출력이 하나면 PDF로 바로 내려받습니다. zip은 표준 DEFLATE로 압축하므로 어느 시스템에서든 풀 수 있습니다.
지금은 안 됩니다. 도구가 책갈피 구조를 해석하지도, 본문을 인식하지도 않습니다. 뷰어에서 장 시작 페이지를 확인한 뒤 범위로 입력하세요.
분할 자체는 페이지를 한 장씩 복사하므로 속도가 페이지 수와 페이지당 용량에 비례하고, 썸네일 생성도 시간을 차지합니다. 모바일 브라우저는 메모리가 더 빠듯하니 수백 페이지 스캔본은 컴퓨터에서 처리하는 편이 좋습니다.
책갈피는 문서 수준 구조라 페이지 단위 복사로는 따라오지 않습니다. 구현 방식상의 필연적인 대가이며 출력 파일 자체는 완전합니다.
결과는 같고 진입 방식이 다릅니다. 선택 페이지는 썸네일을 클릭하는 방식이라 드문드문한 페이지를 눈으로 확인하며 고르기 좋고, 범위 지정은 입력 방식이라 여러 페이지가 이어진 구간에 좋습니다. 둘 다 파일 하나를 출력합니다(범위 지정은 기본이 범위마다 한 파일이고, 병합 스위치를 켜면 하나가 됩니다).
파일은 브라우저 안에서 읽고 분석하고 다시 만듭니다. 어떤 서버도 거치지 않습니다. 페이지 썸네일은 pdf.js가, 출력 파일은 pdf-lib이 이 기기에서 만들고 zip 묶음도 마찬가지입니다. 인터넷이 끊겨도 쓸 수 있고, 페이지를 닫으면 메모리 속 데이터가 해제됩니다.
copyPages와 문서 생성 API: https://pdf-lib.js.org/(访问日期:2026-09-08)2026-09-09 업데이트
페이지 범위, N페이지마다, 선택 페이지 기준으로 분할하거나 페이지별로 내보냅니다
모든 처리는 브라우저 로컬에서 완료되며 파일은 어떤 서버에도 업로드되지 않습니다